摘选原文: https://x.com/servasyy_ai/status/2091416214283379123
官方说明
Qwen3.8 27B 是阿里 8 月 14 日刚开源的模型,Apache 2.0 协议。
27B 稠密参数、原生能看图看视频,但主业是干活:写代码、调工具、读长文。
官方定位就是端侧 Agent 模型,256K 上下文,还能扩到 1M。
“目前最有性价比的端侧 Agent 模型”。
官方跑分 SWE-bench Pro 61.7,号称超 Claude Opus 4.6 Max。
反复用到两个设计:
- 混合注意力:64 层里只有 16 层是全注意力,KV Cache 比传统模型省约 75%——这就是 24GB 游戏卡敢谈十几万字长文的原因
- MTP 官方内置:推测解码头直接做进了模型文件,不用另外下载,开个参数生成速度就翻倍
模型版本
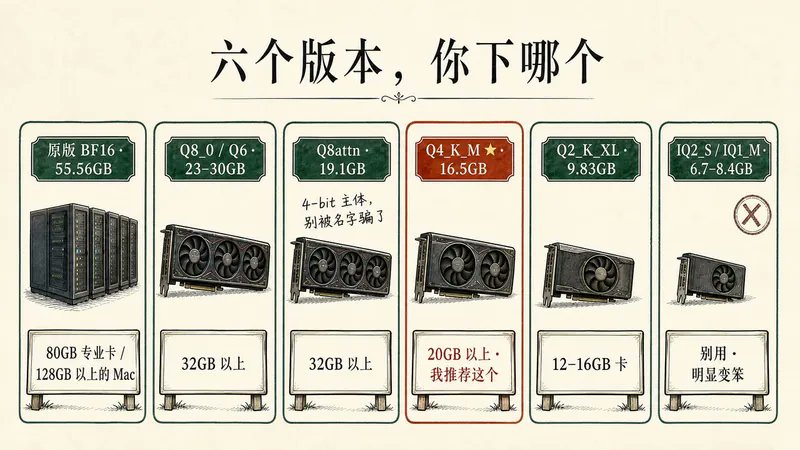
| 版本 | 大小 | 显卡要求 |
|---|---|---|
| 原版 BF16 | 55.56GB | 80GB 专业卡、或 128GB 以上的 Mac |
| Q8_0 / Q6 | 23–30GB | 32GB 以上 |
| Q8attn(4-bit 主体) | 19.1GB | 32GB 以上 |
| Q4_K_M | 16.5GB | 20GB 以上,推荐这个 |
| Q2_K_XL | 9.83GB | 12–16GB 卡 |
| IQ2_S / IQ1_M | 6.7–8.4GB | 别用,明显变笨 |
数字越小、文件越小、越省显存,但压过头会变笨。 原版最准,但要 80GB 级的机器
Q4_K_M 最省的配法(q4 KV、32K)也要 16,338 MiB
核心结论:
- 窗口开大只占显存,不影响速度 —— 真把内容塞满才会慢。这是全文最重要的一条
- 装机全程约 14 分钟(下载 12 分半是大头),国内一定走 hf-mirror 镜像
- 别看文件名猜位数 —— Q8attn 是 4-bit 主体,不是 8-bit
- 量化的代价:答对了,但想得更久 —— 小量化版 tok/s 更高,但可能多想两三倍,总时间反而不省
- 速度配置用 MTP3 就够,新出的 DFlash 2 日常场景还更慢(这是 N 卡结论,Mac 上正好相反,见 6.9)
- 模型跑起来了不代表能用 —— 一定要发个真实请求验证,日志说 model loaded 会骗人
术语表
tok/s(每秒多少字)
模型每秒吐多少字,后面所有速度都用它。参照:人正常阅读约每秒 5–10 字,所以 47 tok/s 就是“你根本读不过它”。
显存 / 统一内存
N 卡用户看显存(显卡上的专用内存),Mac 用户看统一内存(内存显存是同一块,共用)。模型得整个装进这里面才跑得快,这是全篇最重要的硬指标。
量化(Q4、Q6、Q8 这些)
把模型“压缩着存”,压得越狠越省显存,也可能损点精度。数字越小压得越狠:Q2 最省、Q8 最保真。
GB 和 GiB(这两个不是一个东西)
GB 按 1000 进位,GiB 按 1024 进位,同一个文件用两种单位写出来数字不一样——比如 Q2_K_XL 写成 9.83GB 和 9.15GiB 是同一个文件,别以为是两个版本。本文正文统一用 GB;只有下载命令附近标注 GiB,因为 HuggingFace 页面和 wget 进度条显示的是 GiB,照着核对文件大小时别对不上号。
窗口
模型一次最多能记住多少内容,像桌子多大。启动时可以设成 32K(小桌)或 256K(大长桌)。记住:桌子大 ≠ 干活慢。
预处理(Prefill)
把内容发过去,模型不会立刻开口——它得先把发的内容从头处理一遍(建立 KV Cache)才开始答。这段等待就是预处理。发两句话 0.2 秒;发 25 万 token,三分半钟。
KV Cache
模型处理输入时缓存下来的中间结果。有了它,生成每个新 token 时不用把前面的内容重算一遍。上下文越长,KV Cache 越大,占的显存越多——这是显存消耗的大头之一。
MTP(多 token 预测)
一种加速技术:让模型提前预测接下来的几个 token,验证通过就一次输出多个,省下逐字生成的时间。预测命中的比例叫“接受率”——接受率高就快,低了反而更慢(白算一遍)。
KV Cache 也能量化(q8 / q4)
KV Cache 本身也可以压缩存储。q8 精度高、占显存多;q4 省一半显存、精度低一些。KV Cache 分 K 和 V 两部分,可以分开设置(比如 K 用 q8、V 用 q4),这是常见做法。
空载 / 满载
对比速度时会用这两个词:空载指窗口开着但只发了一两句话;满载指真把窗口塞满了内容。这两种情况速度差很多。
offload(分层放)
大模型分很多层。层放显卡上跑得快但吃显存,挪到内存省显存但慢。显存不够时靠它续命。
ubatch(一次读几页)
模型读你发的内容时,一次处理多少。像看书一次翻几页——翻多几页可能读得更快,但不是越多越好。
冷启动 / 热启动
冷启动是刚开机、模型还没进显存,第一次加载要多等一会儿;热启动是已经跑过一轮,再启动就快得多。
基础准备
Q4_K_M 是分割线
如表,同一个模型 Q4_K_M,答题质量一样(72 题 47 分,全文最高),不存在“用质量换窗口”。 每格的速度都标了是“长文”还是“短任务”。
| 显卡容量 | 配置一:优先长窗口 | 配置二:优先速度 |
|---|---|---|
| 18GB | q4 KV、64K,17,090 MiB,长文 40.36 tok/s | 同左(MTP 贴线:18,148 MiB 只剩 284MiB,不建议开) |
| 20GB | q4 KV、128K,18,548 MiB,长文 33.56 tok/s | q4 KV + MTP3、32K,18,148 MiB,短任务 105.70 tok/s(全文最快) |
| 24GB | q4 KV 不开 MTP、256K,21,492 MiB,长文 25.25 tok/s,25 万字 17/17 | q4 KV + MTP3、192K,22,637 MiB,长文 59.52 tok/s |
| 32GB 及以上 | q4 KV + MTP3、256K,24,422 MiB,长文 53.15 tok/s | 同左,已经是这张卡的最优解 |
推荐 Q4_K_M,是因为质量测不出差距的前提下,它更省显存、也更容易在 24GB 卡上跑起来。要是有 32GB 以上、又想榨满 256K 的速度,Q8attn q4/q4 是更快的那个。
模型压缩
Qwen3.8 27B 的官方原版——没经过任何压缩的完整版——18 个权重文件加起来 55.56GB。
先看看市面上的卡都有多少显存:官方版 4090 是 24GB,5090 是 32GB,绝大多数人手里的卡在 8–24GB 之间。没有一张消费级显卡装得下 55.56GB。
压缩了为什么还能用?
用照片打比方。
一张单反原图 50MB,发微信被压成 2MB,你看还是那张照片,脸还是那张脸。因为照片里大量信息是冗余的——天空那一大片蓝,不需要每个像素都存精确数值。
模型也一样。模型里存着几百亿个数字(权重),原版每个数字用 16 位存,精确得要命。但很多数字并不需要那么高精度——把 3.14159265 存成 3.14,模型的判断基本不变。
量化干的就是这件事:用更少的位数存每个数字。
- 原版(BF16):每个数字 16 位,最精确,最占地方(55.56GB)
- Q8:压到 8 位,体积减半,精度损失很小(约 30GB)
- Q4:压到 4 位,再减半(约 16GB)
- Q2:压到 2 位,极限压缩(约 10GB)——按常理该崩了,但实测出乎意料
为什么同样是 4 位,压法不一样
同样压到 4 位,不同格式的压法差别很大:有的按固定块粗切,有的(比如英伟达的 NVFP4)分块更细、每块单独缩放。英伟达官方说这样精度损失的风险更低——我一度信了,主力用了它好几个月,测了四轮也没验证出来。
- 默认推荐 Q4_K_M(任何显卡,只要装得下)——16.5GB、思考最省、单任务最快,四轮测试没观察到质量劣势
- 32GB 及以上要跑满 256K 长文:Q4_K_M + q4 KV + MTP3(24,422 MiB,长文 53.15 tok/s)——质量(47 vs 41)和显存都更省,推荐的首选;Q8attn(30.3GB,长文 47.70)常驻配置
- 24GB:Q4_K_M + q4 KV + MTP3,开到 192K(22.6GB,59.52 tok/s)。别硬开 256K,只剩 154MiB
- 18–20GB:Q4_K_M + q4 KV。18GB 能开 64K(17,090 MiB,长文 40.36 tok/s),20GB 能开 128K(18,548 MiB,长文 33.56 tok/s);MTP 在 32K 只多吃 1.81GB,20GB 卡开得起(18,148 MiB,短任务 105.70 tok/s),18GB 开了就贴线(不建议)
- 12–16GB:Q2_K_XL,12GB 跑 32K(10.92GB),16GB 能到 128K(14.66GB)。限定:这是短任务的结论——agent 长任务社区数据显示 2-bit 会掉两成完成率,16GB 卡可以优先试没测过的 Q3_K_XL(12.24 GiB)或 IQ4_XS(13.27 GiB)
- 8GB 及以下:没测出可用的全 GPU 方案。混合卸载能启动,但速度太差,不推荐
窗口、内容、显存
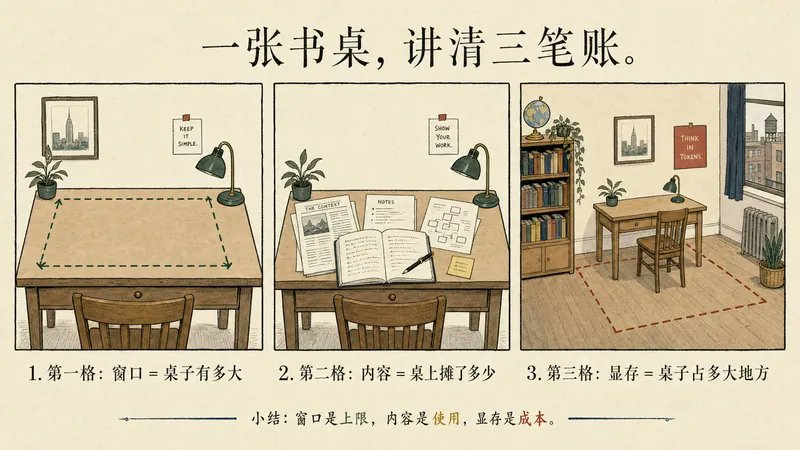
窗口 = 桌子有多大。
可以买张小书桌(32K),也可以买会议室那么长的桌(256K)。买大桌子唯一的代价是占地方——这里就是占显存。桌子大小跟干活快慢没关系。
内容 = 在桌上摊了多少纸。
可以在大长桌上只摊一张纸,也可以摊满 25 万 token。摊多少纸,才决定干活快慢。
为什么纸越多越慢?这个机制得讲透。
模型每写下一个新字之前,都要回头把桌上所有的纸扫一遍——这就是“注意力机制”:它要确保新写的字跟前面所有内容都对得上。
桌上一张纸,扫一眼就完事,唰唰唰地写。桌上摊了 25 万 token,它每写一个字都得把这 25 万 token 扫一遍;写第二个字,再扫一遍;第三个字,再扫一遍……
所以内容越长,每个字的成本越高,吐字速度就掉下来。这不是模型偷懒,是它的工作方式决定的。
还有一步:动笔前得先通读。 模型开写前要把桌上的纸读一遍、记好笔记(预处理)。25 万 token,光通读就三分半钟。
显存只跟窗口有关
实测的显存占用,全程只跟窗口大小有关,跟实际发多少内容没关系:
- 32K 窗口:20.4GB
- 64K 窗口:21.8GB
- 128K 窗口:24.6GB
- 256K 窗口:30.3GB
为什么?因为模型启动时就把桌子的地方占了——先把那张 256K 的大桌摆好、KV Cache 分配好。这是预留,不是实际用量。
最硬的一组证据:同一个配置,空载 vs 满载
同样开着 256K 窗口、同样的 KV Cache 精度、同样的 MTP 设置,只有“实际塞了多少内容”不同:
同一配置(256K 窗口 / q8 KV / MTP3)下:
- 空载(只发一句短话):78.80 tok/s,峰值显存 30,272 MiB
- 填满 250K token:47.70 tok/s,峰值显存 30,280 MiB
看这两行:
- 显存几乎完全一样(差 8 MiB,等于没差)——因为 256K 那张大桌子的位置,启动时就预留好了,用不用得上,它都占着
- 速度掉了 39.5%(空载是满载的 1.65 倍)——掉速的原因就是真的把纸摊满了
开大窗口主要增加显存;把内容填满,才会明显拖慢生成。 把书桌换大,和真的读完一摞书,是两件事。
所以显存够就把窗口开大,别省。 平时聊两句不吃亏,需要时能一次塞进一整本书。
一个体感数字:这个配置下,从按回车到蹦出第一个字,中位数 90.8 毫秒(第一次冷启动 226 毫秒)。不到 0.1 秒就开始出字,日常对话完全没有等待感。
部署
推理框架(llama.cpp):
#官方上游的 llama.cpp,不是任何第三方魔改版。
llama.cpp build: b10441(commit 0177dcc7)
系统:Ubuntu 24.04.3 LTS
CUDA:12.0.140
显卡驱动:595.71.05
GPU 架构:Ada(sm_89)
模型依赖 Qwen3.8、NVFP4 和 MTP 支持,旧版 llama.cpp 跑不起来
安装编译:
sudo apt-get update
sudo apt-get install -y git wget openssl build-essential python3-venv ninja-build

python3 -m venv ~/apps/llama-cuda-build-venv
~/apps/llama-cuda-build-venv/bin/pip install cmake==4.4.2

git clone https://github.com/ggml-org/llama.cpp.git ~/apps/llama.cpp-b10441-cuda-src
git -C ~/apps/llama.cpp-b10441-cuda-src checkout 0177dcc7300bad8914bb838baabce87899812491

#编译
~/apps/llama-cuda-build-venv/bin/cmake -S ~/apps/llama.cpp-b10441-cuda-src -B ~/apps/llama.cpp-b10441-cuda-src/build-cuda \
  -DCMAKE_BUILD_TYPE=Release -DGGML_CUDA=ON -DGGML_CUDA_FA=ON -DCMAKE_CUDA_ARCHITECTURES=89

~/apps/llama-cuda-build-venv/bin/cmake --build ~/apps/llama.cpp-b10441-cuda-src/build-cuda --config Release -j 16 其中,
-DCMAKE_CUDA_ARCHITECTURES 这个数字是显卡架构代号:
- 30 系(3060/3080/3090)→
86 - 40 系(4060/4070/4080/4090)→
89 - 50 系(5070/5080/5090)→
120
验证安装:
~/apps/llama.cpp-b10441-cuda-src/build-cuda/bin/llama-server --version

#version: 0.1.0-dev (build 1, commit 0177dcc)
创建本地 API Key:
umask 077
openssl rand -hex 32 > ~/qwen38-api-key
服务只监听 127.0.0.1(本机),不会暴露到公网。这个 key 是防止本机其他程序误调用。
启动命令:
A档:日常 32K 版:
~/apps/llama.cpp-b10441-cuda-src/build-cuda/bin/llama-server \
  -m ~/models/Qwen3.8-27B-NVFP4-MTP-Q8attn-GGUF/Qwen3.8-27B-NVFP4-MTP-Q8attn.gguf \
  --alias Qwen3.8-27B-NVFP4-MTP-Q8attn \
  --host 0.0.0.0 --port 8080 \
  --ctx-size 32768 \
  --n-gpu-layers 99 --fit off \
  --threads 16 --threads-batch 16 --parallel 1 \
  --batch-size 2048 --ubatch-size 512 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --flash-attn on --jinja \
  --spec-type draft-mtp --spec-draft-n-max 3 \
  --spec-draft-type-k f16 --spec-draft-type-v f16 \
  --spec-draft-backend-sampling \
  --cache-reuse 0 \
--api-key-file ~/qwen38-api-key- --ctx-size 32768 = 桌子多大,这里是 32K
- --cache-type-k/v q8_0 = KV Cache 用什么精度,q8 是清楚详细那档
- --batch-size 2048 --ubatch-size 512 = 一次读多少页,512 是实测最优
- --parallel 1 = 只开一条并发槽位。这个参数值得单独说一句:llama.cpp 会把窗口按并发数平分,默认值不是 1 的版本里,你以为开了 256K,实际每条请求可能只分到一半。自己一个人用就锁 1,等于把整个窗口都留给自己——同样的显存能多出一大截可用窗口
- --spec-draft-n-max 3 = MTP 设成 3,我这台机器实测最优
- --n-gpu-layers 99 = 把所有层都塞进显卡(写个大数就是“全部”)
- --fit off = 禁止它偷偷缩窗口来“勉强启动”,显存不够就直接报错,免得你以为开了 32K、实际只开了 8K
- --flash-attn on = 开启那个省显存的底层算法
- --jinja = 用模型自带的对话模板,OpenAI 接口需要
- --threads 16 = 用 16 个 CPU 线程,改成你的核心数
- --reasoning-effort(思考档位)。 这个模型默认是 xhigh——想得最久、最容易把输出预算吃光。
加入:
--reasoning-effort medium \- 可选 xhigh(默认)/ high / medium / low,也可以设 none 整个关掉思考
- 什么时候调低:日常问答、写作这类不需要深度推理的活,medium 足够,响应明显变快
- 什么时候关掉:小显存 / 16GB Mac 这种性能紧张的机器,思考本身也占输出预算和时间,关掉能省一大截
- 想太久 → 吃光输出预算 → 答案被截断 → 看起来像“变笨”。发现模型突然变笨,除了检查输出上限,也检查一下思考档位是不是没必要地开在 xhigh
B 档:256K 稳妥(32GB 卡跑长文用)
跟 A 档只差两处:窗口 262144(256K),V cache 压到 q4_0
~/apps/llama.cpp-b10441-cuda-src/build-cuda/bin/llama-server \
  -m ~/models/Qwen3.8-27B-NVFP4-MTP-Q8attn-GGUF/Qwen3.8-27B-NVFP4-MTP-Q8attn.gguf \
  --alias Qwen3.8-27B-NVFP4-MTP-Q8attn \
  --host 127.0.0.1 --port 8080 \
  --ctx-size 262144 \
  --n-gpu-layers 99 --fit off \
  --threads 16 --threads-batch 16 --parallel 1 \
  --batch-size 2048 --ubatch-size 512 \
  --cache-type-k q8_0 --cache-type-v q4_0 \
  --flash-attn on --jinja \
  --spec-type draft-mtp --spec-draft-n-max 3 \
  --spec-draft-type-k f16 --spec-draft-type-v f16 \
  --spec-draft-backend-sampling \
  --cache-reuse 0 \
  --api-key-file ~/qwen38-api-key
C 档:24GB 卡的安全配置(192K)
这是 24GB 显卡的推荐档——用 Q4_K_M 模型,K/V 都压到 q4 q4,窗口开到 192K 而不是 256K。
#Unsloth 的动态量化版 UD-Q4_K_M
mkdir -p ~/models/Qwen3.8-27B-GGUF

wget -c -O ~/models/Qwen3.8-27B-GGUF/Qwen3.8-27B-UD-Q4_K_M.gguf \
  'https://hf-mirror.com/unsloth/Qwen3.8-27B-GGUF/resolve/main/Qwen3.8-27B-UD-Q4_K_M.gguf?download=true'


#启动命令
~/apps/llama.cpp-b10441-cuda-src/build-cuda/bin/llama-server \
  -m ~/models/Qwen3.8-27B-GGUF/Qwen3.8-27B-UD-Q4_K_M.gguf \
  --alias Qwen3.8-27B-Q4 \
  --host 127.0.0.1 --port 8080 \
  --ctx-size 196608 \
  --n-gpu-layers 99 --fit off \
  --threads 16 --threads-batch 16 --parallel 1 \
  --batch-size 2048 --ubatch-size 512 \
  --cache-type-k q4_0 --cache-type-v q4_0 \
  --flash-attn on --jinja \
  --spec-type draft-mtp --spec-draft-n-max 3 \
  --spec-draft-type-k f16 --spec-draft-type-v f16 \
  --spec-draft-backend-sampling \
  --cache-reuse 0 \
  --api-key-file ~/qwen38-api-key
检查启动:
#健康检查
export QWEN_API_KEY="$(head -n 1 ~/qwen38-api-key)"
curl -sS -H "Authorization: Bearer ${QWEN_API_KEY}" http://127.0.0.1:8080/health
# {"status":"ok"}

#测试
curl -sS http://127.0.0.1:8080/v1/chat/completions \
  -H "Authorization: Bearer ${QWEN_API_KEY}" \
  -H 'Content-Type: application/json' \
  -d '{"model":"Qwen3.8-27B-NVFP4-MTP-Q8attn","messages":[{"role":"user","content":"只回复:QWEN_OK"}],"temperature":0,"max_tokens":128,"stream":false}'
其他
vLLM + W4A16:真快,250K 下 68.0 tok/s,比我的方案快 40%。但要占 45.5GB——我这卡还得留给别的服务,装不下。
显卡专门伺候一个模型的,W4A16 就是最优解